BLOG
KI in der klinischen Datenanalyse: Wo sie hilft und wo Risiken entstehen
KI kann klinische Datenanalysen schneller vorbereiten, Muster sichtbar machen und Auswertungsprozesse unterstützen. In klinischen Studien reicht Geschwindigkeit allein jedoch nicht aus. Entscheidend ist, ob eine Analyse nachvollziehbar, reproduzierbar und fachlich zur Fragestellung passt.
Gerade bei klinischen Daten treffen KI-Systeme auf hohe Anforderungen: definierte Endpunkte, festgelegte Analysepopulationen, regulatorische Dokumentation, sensible Studiendaten und mögliche Auswirkungen auf medizinische Entscheidungen. Deshalb sollte KI in der klinischen Datenanalyse als unterstützendes Werkzeug verstanden werden, nicht als Ersatz für statistische Verantwortung.
Einen allgemeinen Überblick dazu, wo KI Statistik unterstützen kann und warum fachliche Einordnung wichtig bleibt, bietet der Novustat-Artikel zu KI in der Statistik. In klinischen Datenanalysen verschärfen sich diese Fragen, weil Studiendesign, Datenqualität und klinische Interpretation enger zusammenhängen.
Was bedeutet KI in der klinischen Datenanalyse?
KI in der klinischen Datenanalyse beschreibt den Einsatz automatisierter oder lernender Verfahren innerhalb klinischer Auswertungsprozesse. Dazu können klassische Machine-Learning-Modelle, regelbasierte Systeme, Natural-Language-Processing-Verfahren oder generative KI-Werkzeuge gehören.
Der Unterschied zum allgemeinen Einsatz von KI in der Statistik liegt im klinischen Kontext. Es geht nicht nur um die Frage, ob ein Tool eine Syntax schreiben, einen Test erklären oder Ergebnisse zusammenfassen kann. Klinische Datenanalysen sind an Studienprotokoll, Endpunkte, Analysepopulationen, Datenmanagement, Monitoring und regulatorische Nachvollziehbarkeit gebunden.
In der Praxis kann KI deshalb sehr unterschiedliche Rollen haben. Sie kann Analysefragen strukturieren, Datenmuster vorprüfen, auffällige Verteilungen markieren, Programmcode kommentieren oder Ergebnisbeschreibungen für den Review vorbereiten. Diese Anwendungen unterscheiden sich stark in ihrem Risiko. Ein KI-Tool, das eine R-Syntax kommentiert, ist anders zu bewerten als ein Modell, das Subgruppen identifiziert oder klinische Endpunkte vorhersagt. Für klinische Datenanalysen ist deshalb entscheidend, welche Aufgabe KI übernimmt und wie das Ergebnis kontrolliert wird.
Wo KI klinische Auswertungen sinnvoll unterstützen kann
KI kann in klinischen Datenanalysen vor allem dort helfen, wo wiederkehrende, klar begrenzte oder vorbereitende Aufgaben anfallen. Der Mehrwert liegt weniger in der vollautomatischen Entscheidung und stärker darin, Prüfstellen schneller sichtbar zu machen.
Ein typischer Einsatzbereich ist die explorative Vorbereitung. KI kann Variablenbeziehungen sichtbar machen, ungewöhnliche Verteilungen markieren oder Hinweise auf Dateninkonsistenzen geben. In klinischen Studien kann das hilfreich sein, wenn viele Messzeitpunkte, Zentren, Subgruppen oder wiederholte Erhebungen zusammenkommen.
Auch bei der Vorbereitung von Tabellen, Listings und Abbildungen kann KI unterstützen. Sie kann Code-Skelette vorschlagen, Prüfregeln formulieren oder Ergebnisbeschreibungen für den Review strukturieren. Entscheidend ist dabei, dass die finale Auswertung weiterhin gegen Studienprotokoll, Analyseplan und validierte Datensätze geprüft wird.
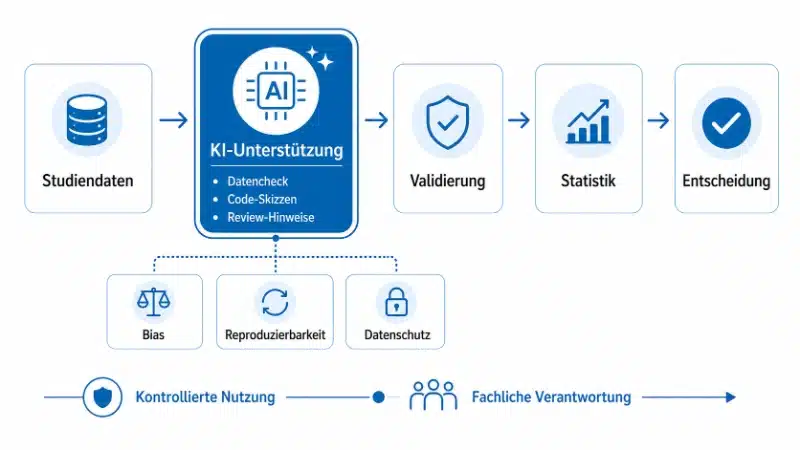
Sinnvoll ist KI vor allem bei klar begrenzten Aufgaben. Praktisch geht es dabei häufig um Datencheck, Code-Skizzen und Review-Hinweise:
- Datencheck: Vorprüfung von Datenmustern, auffälligen Verteilungen und möglichen Inkonsistenzen
- Code-Skizzen: erste Struktur für Auswertungscode, Prüfregeln oder Tabellenprogramme
- Review-Hinweise: Markierung unklarer Formulierungen, Widersprüche oder Dokumentationslücken
Hilfreich kann KI außerdem als Review-Werkzeug sein. Sie kann Inkonsistenzen in Dokumentation, unklare Formulierungen oder potenzielle Widersprüche zwischen Analyseplan, Datensatz und Ergebnisdarstellung sichtbar machen. Die Grenze verläuft dort, wo KI von der Unterstützung in die eigenständige methodische Entscheidung rutscht. Welche Analysepopulation relevant ist, wie mit fehlenden Werten umzugehen ist oder ob ein Ergebnis klinisch sinnvoll interpretiert werden kann, lässt sich nicht zuverlässig an ein generisches Modell delegieren.
Warum klinische Daten besondere Anforderungen haben
Klinische Daten unterscheiden sich von vielen anderen Datensätzen, weil sie in einen Studienkontext eingebettet sind. Jede Variable hat eine fachliche Bedeutung, jede Auswertung steht in Beziehung zu Studiendesign, Endpunktdefinition, Fallzahlplanung, Analysepopulation und Dokumentationspflichten.
Ein Modell kann statistische Muster erkennen, ohne den klinischen Kontext angemessen zu verstehen. Genau darin liegt ein zentrales Risiko. Ein auffälliges Signal kann methodisch interessant wirken, aber durch Rekrutierung, Messzeitpunkte, Dropouts, Begleitmedikation oder Protokollabweichungen erklärbar sein.
Hinzu kommt, dass klinische Studien häufig vorab definierte Analysewege benötigen. Der Statistical Analysis Plan legt fest, welche Endpunkte, Populationen, Modelle und Sensitivitätsanalysen relevant sind. Wenn KI nachträglich Muster findet, muss klar sein, ob es sich um explorative Hinweise oder um vorab geplante Analysen handelt.
Auch Datenqualität und Nachvollziehbarkeit spielen eine zentrale Rolle. Klinische Studiendaten müssen dokumentierbar, prüfbar und reproduzierbar ausgewertet werden. Eine Analyse ist nur dann belastbar, wenn sich nachvollziehen lässt, welche Daten verwendet wurden, welche Verarbeitungsschritte erfolgt sind und warum ein bestimmtes Ergebnis entstanden ist. Hier berührt KI unmittelbar Fragen von Audit Trail und Datenintegrität.
Patientendaten, Datenschutz und Pseudonymisierung gehören ebenfalls auf die Prüfliste. In diesem Artikel bleiben sie bewusst ein kurzer Hinweis, weil die konkreten Herausforderungen einen eigenen Schwerpunkt brauchen. Für KI-gestützte klinische Datenanalysen gilt jedoch immer: Vor Toolnutzung, Datenübertragung oder Modelltraining muss geklärt sein, welche Daten überhaupt verwendet werden dürfen.
Risiken bei Bias, Reproduzierbarkeit und Interpretation
Die größten Risiken von KI in der klinischen Datenanalyse entstehen selten durch offensichtliche Fehler. Problematischer sind plausibel wirkende Ergebnisse, die methodisch nicht zur Fragestellung, Datenstruktur oder Studienlogik passen.
Bias ist dabei ein zentrales Thema. KI-Modelle lernen aus vorhandenen Daten. Wenn bestimmte Patientengruppen unterrepräsentiert sind, Messverfahren systematisch variieren oder historische Daten Verzerrungen enthalten, kann ein Modell diese Muster übernehmen oder verstärken. In klinischen Studien können Verzerrungen zusätzlich aus Studienpopulation, Zentrenstruktur, Messrhythmus oder Dropout-Mustern entstehen. Das kann die Interpretation von Wirksamkeit, Sicherheit oder Subgruppenbefunden beeinflussen.
Ein weiteres Risiko betrifft Reproduzierbarkeit. Viele KI-Workflows sind schwerer nachzuvollziehen als klassische statistische Auswertungen. Das gilt besonders, wenn generative KI, nicht dokumentierte Prompts, wechselnde Modellversionen oder externe Tools beteiligt sind. Für klinische Forschung ist das heikel, weil Ergebnisse prüfbar und wiederholbar sein müssen.
Auch die Interpretation ist anspruchsvoll. KI kann Zusammenhänge identifizieren, ohne kausale Bedeutung zu liefern. Ein Modell kann eine Variable als relevant markieren, obwohl sie nur ein Surrogat für Rekrutierungszentrum, Erkrankungsschwere oder Messhäufigkeit ist. Solche Muster können analytisch interessant sein, aber klinisch in die falsche Richtung führen.
Besonders kritisch wird es, wenn Trainings- oder Eingabedaten unklar sind, Toolversionen wechseln oder Prompts und Parameter nicht dokumentiert werden. Auch Scheinkorrelationen in kleinen oder selektiven Datensätzen sind ein praktisches Problem. Ein Muster, das in einer Studie sichtbar wird, kann in einer anderen Population verschwinden oder dort eine andere Bedeutung haben.
Für klinische Studien kommt eine weitere Ebene hinzu: Explorative Hinweise und konfirmatorische Analysen müssen sauber getrennt bleiben. Wenn KI nachträglich interessante Subgruppen, Endpunktmuster oder Prädiktoren findet, kann daraus eine Hypothese entstehen. Daraus folgt aber noch kein belastbarer Wirksamkeits- oder Sicherheitsnachweis.
KI-Ergebnisse sollten deshalb nicht danach bewertet werden, ob sie überzeugend formuliert oder visuell plausibel wirken. Entscheidend ist, ob sie methodisch erklärbar, klinisch sinnvoll und mit den Studiendaten reproduzierbar sind.
Warum KI-Ergebnisse fachlich validiert werden müssen
Validierung bedeutet in der klinischen Datenanalyse mehr als ein kurzer Plausibilitätsblick. Es geht darum zu prüfen, ob ein KI-gestütztes Ergebnis methodisch korrekt, nachvollziehbar, robust und für die konkrete Fragestellung geeignet ist.
Eine sinnvolle Validierung beginnt bei der Aufgabenbeschreibung. Vor dem Einsatz eines KI-Tools sollte klar sein, ob es um Datenprüfung, Codeunterstützung, explorative Mustererkennung, Modellierung oder Ergebnisinterpretation geht. Je stärker ein KI-Ergebnis in fachliche Entscheidungen einfließt, desto strenger müssen Kontrolle und Dokumentation sein.
Bei klinischen Analysen reicht es nicht, ein Ergebnis plausibel zu finden. Es muss gegen den vorab definierten Analyseplan geprüft werden. Die verwendete Datenbasis muss nachvollziehbar sein. Zentrale Ergebnisse sollten unabhängig reproduziert werden können. Toolversionen, Parameter oder Prompts müssen so dokumentiert sein, dass ein Review möglich bleibt. Bei modellabhängigen Ergebnissen können Sensitivitätsanalysen helfen, die Robustheit der Schlussfolgerung einzuschätzen.
Vor dem Einsatz eines KI-Tools sollten deshalb mindestens vier Fragen geklärt sein:
- Welche konkrete Aufgabe übernimmt die KI?
- Welche Daten, Versionen und Parameter werden verwendet?
- Wie wird das Ergebnis unabhängig geprüft?
- Welche Entscheidung bleibt ausdrücklich beim Studienteam?
Internationale und regulatorische Diskussionen zu KI in Arzneimittelentwicklung, Medizinprodukten und klinischer Forschung betonen zunehmend Risiko-Management, Datenqualität, menschliche Aufsicht und Nachvollziehbarkeit. Das passt zu einem Grundprinzip klinischer Statistik: Eine Analyse muss rechnerisch funktionieren, fachlich begründet sein und unabhängig überprüft werden können.
KI kann in diesem Rahmen nützlich sein, wenn ihre Ergebnisse systematisch geprüft werden. Sie wird problematisch, wenn sie Entscheidungen verdeckt, Dokumentation ersetzt oder scheinbare Objektivität erzeugt. Gerade in klinischen Studien sollten KI-gestützte Arbeitsschritte deshalb so dokumentiert werden, dass ein unabhängiger Reviewer nachvollziehen kann, was passiert ist.
Wann klassische Statistik unverzichtbar bleibt
Klassische Statistik bleibt unverzichtbar, wenn es um Studiendesign, Hypothesenprüfung, Fallzahlplanung, konfirmatorische Auswertung und regulatorisch relevante Schlussfolgerungen geht. KI kann hier unterstützen, aber die methodische Verantwortung bleibt bei qualifizierten Personen.
Besonders deutlich wird das bei vorab geplanten Analysen. Der primäre Endpunkt einer klinischen Studie, die Analysepopulation, der Umgang mit fehlenden Daten und die Interpretation von Sensitivitätsanalysen sind keine reinen Rechenaufgaben. Sie verbinden Statistik, medizinische Fragestellung und regulatorische Nachvollziehbarkeit.
Auch bei explorativen KI-Ergebnissen braucht es klassische statistische Einordnung. Ein auffälliges Muster kann eine Hypothese erzeugen, aber es ersetzt keine sauber geplante Prüfung. Wer KI-Ergebnisse unmittelbar als Evidenz behandelt, riskiert Überinterpretation, Selektionsbias und scheinbar präzise Schlussfolgerungen aus unsicheren Daten.
Klinische Datenanalyse braucht deshalb beides: effiziente Werkzeuge und methodische Disziplin. KI kann Hinweise liefern, Routinen beschleunigen und Reviews unterstützen. Die Bewertung, ob ein Ergebnis belastbar, klinisch relevant und reproduzierbar ist, bleibt eine statistische und fachliche Aufgabe.
Fazit
KI kann klinische Datenanalysen sinnvoll unterstützen, wenn ihr Einsatz klar begrenzt, dokumentiert und fachlich kontrolliert wird. Besonders hilfreich ist sie bei vorbereitenden Aufgaben, Datenchecks, Codeunterstützung, Strukturierung und zusätzlichem Review.
Die Risiken entstehen dort, wo KI-Ergebnisse ungeprüft übernommen oder als methodische Entscheidung missverstanden werden. Klinische Daten stellen besondere Anforderungen an Bias-Kontrolle, Reproduzierbarkeit, Validierung, Patientendatenprüfung und regulatorische Nachvollziehbarkeit.
Für klinische Studien gilt daher: KI kann Analyseprozesse effizienter machen, aber sie ersetzt keine statistische Verantwortung. Belastbare Ergebnisse entstehen erst, wenn KI-Unterstützung, Studiendesign, Datenqualität und fachliche Validierung zusammen gedacht werden.
FDA: Artificial Intelligence & Medical Products – How CBER, CDER, CDRH, and OCP are Working Together: https://www.fda.gov/science-research/science-and-research-special-topics/artificial-intelligence-and-medical-products
FDA: Using Artificial Intelligence & Machine Learning in the Development of Drug and Biological Products: https://www.fda.gov/media/167973/download?attachment=
European Commission CT-3 Guidance zu Adverse Event Reporting in Clinical Trials: https://eur-lex.europa.eu/LexUriServ/LexUriServ.do?uri=OJ:C:2011:172:0001:0013:EN:PDF
European Medicines Agency / HMA: Artificial intelligence workplan to 2028: https://www.ema.europa.eu/en/about-us/how-we-work/data-regulation-big-data-other-sources/artificial-intelligence
Regulation (EU) 2024/1689, Artificial Intelligence Act: https://eur-lex.europa.eu/eli/reg/2024/1689/oj
ICH E6(R3): Guideline for Good Clinical Practice: https://database.ich.org/sites/default/files/ICH_E6%28R3%29_Step4_FinalGuideline_2025_0106.pdf
KI in der klinischen Datenanalyse sicher und sinnvoll einsetzen.
NOVUSTAT unterstützt Sie bei der statistischen Planung und Auswertung klinischer Studien. Wir helfen Ihnen, KI-gestützte Analyseverfahren kritisch zu bewerten, methodische Risiken zu erkennen und die Qualität sowie Nachvollziehbarkeit Ihrer statistischen Ergebnisse sicherzustellen.
Besprechen Sie Ihr Studienvorhaben mit unseren Statistikexperten und erhalten Sie eine unverbindliche Ersteinschätzung.