KI für Datenqualität in klinischen Studien: Wie sie die Datenbereinigung unterstützt
Ein Eintrag im Studiendatensatz kann auffällig sein, ohne zwangsläufig fehlerhaft zu sein. Ein Laborwert kann mit der falschen Einheit erfasst sein, ein Visitdatum kann nicht zur vorgesehenen Visitenfolge passen oder ein medizinisch ungewöhnlicher, aber korrekter Wert kann vorliegen. Solche Auffälligkeiten müssen vor der statistischen Auswertung nach dem vorgesehenen Prozess geprüft und soweit möglich geklärt oder nachvollziehbar dokumentiert sein.
KI kann die Datenqualität in diesem Prozess unterstützen. Sie kann große Datenmengen nach Auffälligkeiten und komplexeren Mustern durchsuchen, potenzielle Queries priorisieren und wiederkehrende Prüfungen unterstützen. Die eigentliche Datenbereinigung bleibt jedoch eine fachliche Aufgabe. Ein System erkennt ein Signal; ob eine Korrektur erforderlich ist und wie sie begründet wird, entscheiden qualifizierte Personen im Studienkontext.
Diese Trennung ist wichtig, weil eine klinische Studie keine beliebige Datenbank ist. Jede Variable kann mit einer medizinischen Frage, einem Endpunkt oder einer Sicherheitsbewertung verbunden sein. Datenqualität bedeutet deshalb mehr als möglichst wenige Leerfelder oder plausible Zahlenwerte.
Warum Datenqualität lange vor der statistischen Auswertung beginnt
Statistische Verfahren können unklare oder fehlerhafte Studiendaten nicht nachträglich zuverlässig fachlich klären. Sie verarbeiten den Datensatz, der ihnen bereitgestellt wird. Fehlt zu einem relevanten Messzeitpunkt eine Angabe, ist eine Einheit vertauscht oder bleibt eine Protokollabweichung unklar, beeinflusst das den weiteren Auswertungsweg.
Entscheidend ist, ob die Daten die klinische Fragestellung verlässlich abbilden. Bei einem patientenberichteten Endpunkt gehören dazu beispielsweise korrekt zugeordnete Messzeitpunkte und vollständige Fragebögen. Bei Laborwerten sind Einheiten, Referenzbereiche und die zeitliche Zuordnung zur Visite wesentlich. Ein scheinbar kleiner Fehler kann in der Auswertung eine andere Bedeutung bekommen, etwa wenn er eine Veränderung über die Zeit, eine Sicherheitsbewertung oder die Zuordnung zu einer Analysepopulation betrifft.
Die Grundsätze der Good Clinical Practice verlangen daher eine zweckgerechte Qualität der Studiendaten. Praktisch beginnt diese Arbeit bereits bei der Planung. Das Studienteam legt fest, welche Daten besonders kritisch sind, welche Plausibilitätsregeln gelten und wer Auffälligkeiten prüft. KI kann diese Regeln im laufenden Datenmanagement unterstützen, sie aber nicht fachlich ersetzen.
Wo KI Auffälligkeiten und potenzielle Queries schneller sichtbar machen kann
Bei der Datenbereinigung klinischer Studiendaten sind viele Prüfungen wiederkehrend. Einfache Vollständigkeits- oder Datumsprüfungen lassen sich häufig bereits mit klassischen regelbasierten Validierungen abbilden. KI-gestützte Verfahren werden vor allem dort interessant, wo komplexere Muster, ungewöhnliche Kombinationen oder Auffälligkeiten über viele Variablen, Visiten oder Zentren hinweg erkannt und priorisiert werden sollen. Das ist besonders hilfreich bei vielen Zentren, häufigen Visiten oder umfangreichen elektronischen Fallberichtsformularen.
Ein System kann zum Beispiel markieren, dass an einem Zentrum bestimmte Fragebogenwerte auffällig oft fehlen, dass Datumsfolgen wiederholt unplausibel sind oder dass Laborwerte in einer ungewohnten Einheit erscheinen. Auch Queries, also Rückfragen des Datenmanagements an ein Studienzentrum zur Klärung eines Eintrags, lassen sich nach Dringlichkeit vorsortieren. Eine mögliche Inkonsistenz, die einen primären Endpunkt betrifft, braucht in der Regel eine schnellere Prüfung als ein fehlendes optionales Begleitmerkmal.
Der praktische Mehrwert liegt in der Triage. Das Datenmanagement-Team sieht früher, welche Fälle eine fachliche Bewertung benötigen, und kann seine Prüfkapazität gezielter einsetzen. KI kann dabei unter anderem unterstützen bei:
der Muster- und Anomalieerkennung über viele Variablen, Visiten, Zentren oder Datenquellen hinweg,
dem Erkennen ungewöhnlicher Kombinationen, Trends oder zentrumsbezogener Auffälligkeiten,
der Priorisierung potenzieller Queries nach ihrer Relevanz für Sicherheit oder Endpunkte,
der Zusammenführung mehrerer Signale zu begründeten Prüfhinweisen für das Datenmanagement.
Die Vorschläge sind Arbeitsmaterial, keine festgestellten Fehler. Gerade bei klinischen Daten kann eine medizinisch außergewöhnliche Angabe richtig sein. Ein stark erhöhter Laborwert, ein ungeplanter Besuch oder eine Therapieänderung kann für den konkreten Studienverlauf relevant sein und darf nicht allein wegen eines statistischen Musters korrigiert werden.
Warum KI klinische Studiendaten nicht eigenständig korrigieren sollte
Eine Datenkorrektur verändert einen dokumentierten Dateneintrag. Deshalb braucht sie eine nachvollziehbare Grundlage, etwa eine Klärung mit dem Studienzentrum, einen Abgleich mit Quelldaten oder eine dokumentierte Entscheidung nach vorab definierten Regeln.
Ein KI-System kann aus einem auffälligen Wert ableiten, dass eine Zahl wahrscheinlich vertauscht wurde. Es kennt jedoch nicht automatisch die klinische Situation hinter der Eingabe. War die Einheit tatsächlich falsch? Wurde ein besonderer Befund gemessen? Oder gibt es eine Protokollabweichung, die im Datensatz sichtbar bleiben muss? Diese Fragen verbinden medizinisches Wissen, Studienlogik und Datenmanagement.
Automatisierte Korrekturen bergen deshalb ein eigenes Risiko. Sie können echte klinische Signale glätten, eine fehlerhafte Annahme in viele Fälle übertragen oder den Ursprung einer Änderung verschleiern. Auch eine technisch plausible Korrektur ist nur dann angemessen, wenn sie fachlich begründet, autorisiert und dokumentiert ist.
Die Rollen lassen sich klar trennen. KI kann Auffälligkeiten markieren und Informationen für die Prüfung zusammenstellen. Datenmanager, klinische Fachpersonen und gegebenenfalls statistische Expertinnen und Experten beurteilen die Relevanz. Die berechtigte Person veranlasst oder bestätigt die Korrektur nach dem vorgesehenen Prozess.
Wie fachliche Prüfung, Freigabe und Audit Trail zusammenwirken
Ein guter Workflow macht sichtbar, was ein System vorgeschlagen hat und was das Studienteam entschieden hat. Für jeden relevanten Fall sollte nachvollziehbar bleiben, welche Daten vorlagen, welche Prüfung erfolgte, warum eine Änderung vorgenommen oder verworfen wurde und wer sie freigegeben hat.
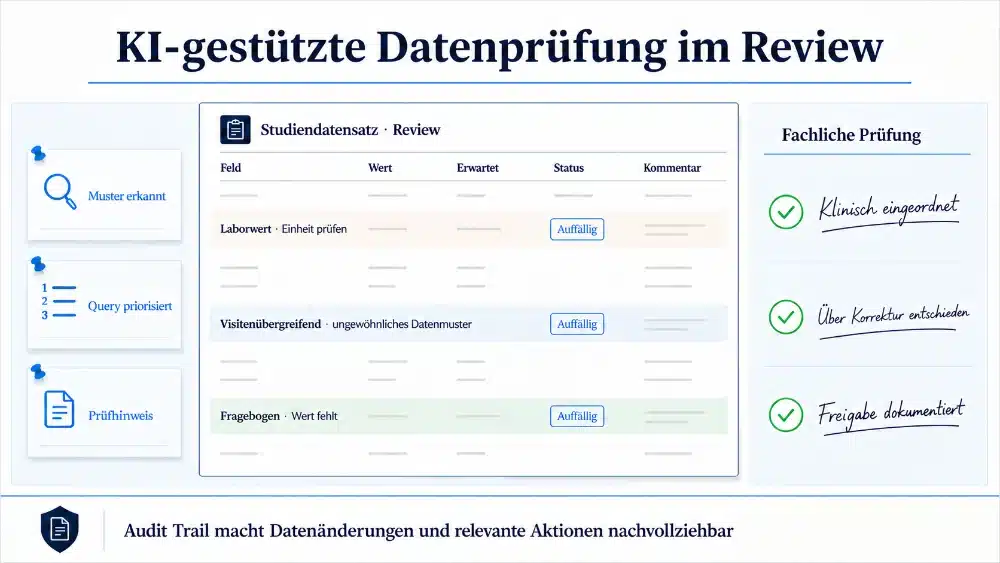
Der Audit Trail ist dafür zentral. Er macht relevante Aktionen und Änderungen an Daten nachvollziehbar, einschließlich ursprünglicher Einträge, Änderungen, Zeitpunkten und verantwortlichen Personen sowie gegebenenfalls der Begründung. Modellversionen, Konfigurationen, Validierungsnachweise, Change Control und weitere technische Informationen können in der dafür vorgesehenen System-, Validierungs- oder Betriebsdokumentation geführt werden. Fachliche Entscheidungen lassen sich je nach Prozess zusätzlich über Query-Historien, Kommentare, Freigaben oder andere vorgesehene Studienunterlagen dokumentieren.
Fachliche Expertise ist an mehreren Stellen erforderlich. Klinische Fachpersonen beurteilen, ob eine Auffälligkeit medizinisch erklärbar ist. Das Datenmanagement bearbeitet Dateninkonsistenzen und Queries und stellt die formale Nachvollziehbarkeit sicher. Soweit ein Abgleich mit Quelldaten erforderlich ist, erfolgt dieser im dafür vorgesehenen Monitoring- oder Prüfprozess. Statistische Beratung hilft dort, wo sich die Datenfrage auf Endpunkte, Analysepopulationen, Zeitfenster oder die spätere Auswertbarkeit auswirkt. Sie kann zum Beispiel beurteilen, ob eine wiederkehrende Inkonsistenz ein einzelnes Datenproblem darstellt oder eine regelmäßige Schwachstelle im Erhebungsprozess offenlegt.
So entsteht ein kontrollierter Prozess: Die Maschine beschleunigt das Auffinden, qualifizierte Personen verantworten die Bewertung und Freigabe. Diese Arbeitsteilung lässt sich auch bei einer späteren Inspektion oder einem unabhängigen Review erklären.
KI unterstützt die Datenprüfung; das Fachteam verantwortet Bewertung und Freigabe, der Audit Trail macht Datenänderungen nachvollziehbar.
Wo ein realer Effizienzgewinn entsteht und wo Risiken beginnen
Ein Effizienzgewinn durch KI entsteht, wenn die gleichen fachlichen Ressourcen früher auf die relevanten Fälle gelenkt werden. Das kann Durchlaufzeiten von Queries verkürzen, wiederkehrende Auffälligkeiten schneller sichtbar machen und Teams bei großen Datenmengen entlasten.
Besonders sinnvoll ist der KI-Einsatz bei klar eingegrenzten Aufgaben, bei denen mehrere Signale zusammengeführt oder Fälle priorisiert werden. Dazu gehören beispielsweise die Erkennung ungewöhnlicher Muster über mehrere Variablen, Visiten oder Zentren sowie die Priorisierung potenzieller Queries anhand mehrerer Relevanzmerkmale. Einfache Vollständigkeits- oder Datumsprüfungen lassen sich dagegen häufig bereits regelbasiert abbilden. Je stärker ein Verfahren fachliche Entscheidungen vorwegnimmt, desto höher sind die Anforderungen an Validierung, Überwachung und Dokumentation.
Risiken entstehen beispielsweise, wenn ein Modell seine Priorisierung auf einer Datenbasis gelernt hat, die nicht zur aktuellen Studie passt. Auch wechselnde Modellversionen, nicht nachvollziehbare Regeln oder unklare Verantwortlichkeiten erschweren die Kontrolle. Der Artikel zu KI in der klinischen Datenanalyse ordnet diese Fragen für die spätere Auswertung, Validierung und Interpretation vertiefend ein.
Wie KI-gestützte Datenbereinigung kontrolliert eingesetzt werden sollte
Ein sinnvoller Start ist ein begrenzter Anwendungsfall. Das Team wählt eine klar definierte Aufgabe, etwa die Priorisierung bereits erkannter Datumsinkonsistenzen anhand mehrerer Relevanzmerkmale, und legt fest, welche Eingaben verwendet werden, welche Hinweise das System ausgeben darf und wer sie prüft. Danach wird verglichen, ob der Prozess relevante Auffälligkeiten früher findet und wie viele Hinweise sich als fachlich nachvollziehbar erweisen. Vor dem produktiven Einsatz definiert das Team den konkreten Anwendungszweck (*Context of Use*). Es prüft, ob die vorgesehene Anwendung, ihre Prüfregeln und ihre Eingabedaten für diesen Zweck geeignet sind. Validierung und Kontrolle richten sich nach dem damit verbundenen Risiko. Die Eignung eines Modells wird für den vorgesehenen Einsatz bewertet. Relevante Änderungen am Modell, an den Regeln oder am Datenfluss werden kontrolliert bewertet und dokumentiert. Bei patientenbezogenen oder anderweitig sensiblen Studiendaten müssen zudem Datenschutz, Zugriffsschutz und die vorgesehenen Data-Governance-Regeln berücksichtigt werden.
Vor dem Routineeinsatz sollten vier Punkte geklärt sein:
Welche fachlich begründeten Regeln oder Muster darf das System prüfen?
Welche Rolle hat der Hinweis im Query- und Freigabeprozess?
Wie werden Modell, Version, Eingabedaten und Entscheidungen dokumentiert?
An welchen Stellen braucht das Team klinische, datenmanagementbezogene oder statistische Expertise?
Die letzte Frage ist besonders wichtig. Statistikberatung wird nicht erst bei der abschließenden Analyse relevant. Sie kann schon im Datenmanagement helfen, kritische Variablen und Zeitfenster zu bestimmen, Prüfregeln auf ihre Auswirkung auf die Auswertung zu beurteilen und die Übergabe eines bereinigten Datensatzes fachlich abzusichern. Einen breiteren Einstieg in den verantwortlichen Einsatz von KI bietet auch der Beitrag zu KI in der Statistik.
Fazit
KI kann Auffälligkeiten in klinischen Studiendaten früh sichtbar machen und Teams bei der Priorisierung unterstützen. Ihr stärkster Nutzen liegt in klar abgegrenzten Datenmanagement-Aufgaben vor der statistischen Auswertung.
Die fachliche Bewertung bleibt dabei unverzichtbar. Klinischer Kontext, Datenintegrität, korrekte Freigaben und die Bedeutung für die spätere Auswertung lassen sich nicht allein aus einem automatisierten Muster ableiten. Ein belastbarer Prozess verbindet deshalb KI-gestützte Hinweise mit qualifizierter Prüfung, nachvollziehbarer Dokumentation und statistischer Expertise an den entscheidenden Schnittstellen.
NOVUSTAT unterstützt Sponsoren, Studienverantwortliche und Forschungseinrichtungen bei der statistischen Planung und Auswertung klinischer Studien. Unsere erfahrenen Biostatistiker beraten Sie zu datenqualitätsrelevanten Fragestellungen, statistischen Analysekonzepten und der Vorbereitung belastbarer Auswertungen.
Besprechen Sie Ihr Studienvorhaben mit unseren Biostatistikern und erhalten Sie eine unverbindliche Ersteinschätzung.
Wir benötigen Ihre Zustimmung, bevor Sie unsere Website weiter besuchen können.Wir verwenden Cookies und andere Technologien auf unserer Website. Einige von ihnen sind essenziell, während andere uns helfen, diese Website und Ihre Erfahrung zu verbessern.Personenbezogene Daten können verarbeitet werden (z. B. IP-Adressen), z. B. für personalisierte Anzeigen und Inhalte oder Anzeigen- und Inhaltsmessung.Weitere Informationen über die Verwendung Ihrer Daten finden Sie in unserer Datenschutzerklärung.Sie können Ihre Auswahl jederzeit unter Einstellungen widerrufen oder anpassen.
Wir verwenden Cookies und andere Technologien auf unserer Website. Einige von ihnen sind essenziell, während andere uns helfen, diese Website und Ihre Erfahrung zu verbessern.Personenbezogene Daten können verarbeitet werden (z. B. IP-Adressen), z. B. für personalisierte Anzeigen und Inhalte oder Anzeigen- und Inhaltsmessung.Weitere Informationen über die Verwendung Ihrer Daten finden Sie in unserer Datenschutzerklärung.Hier finden Sie eine Übersicht über alle verwendeten Cookies. Sie können Ihre Einwilligung zu ganzen Kategorien geben oder sich weitere Informationen anzeigen lassen und so nur bestimmte Cookies auswählen.